oMLX:让智能体等待时间从90秒骤降至5秒的Mac本地LLM推理服务器
让智能体等待时间从90秒骤降至5秒的Mac本地LLM推理服务器
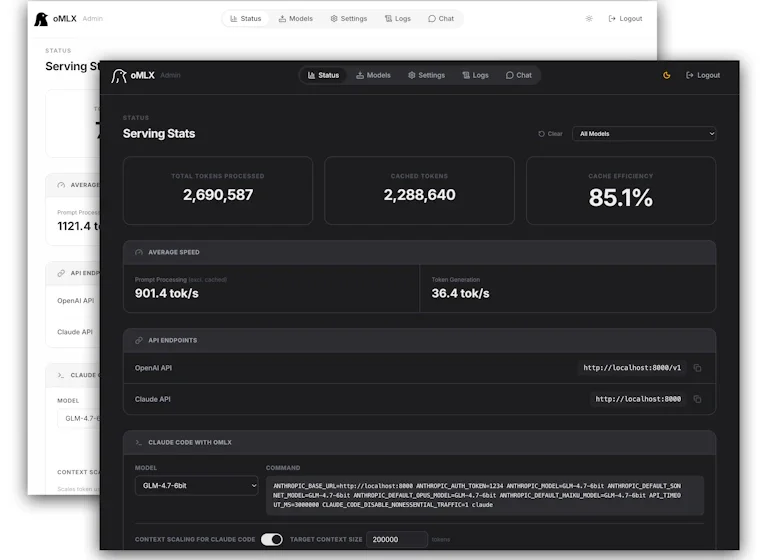
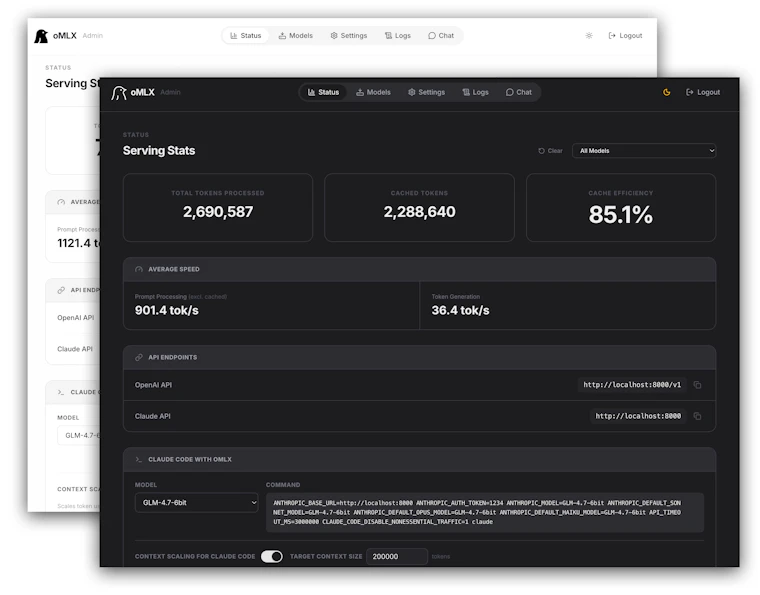
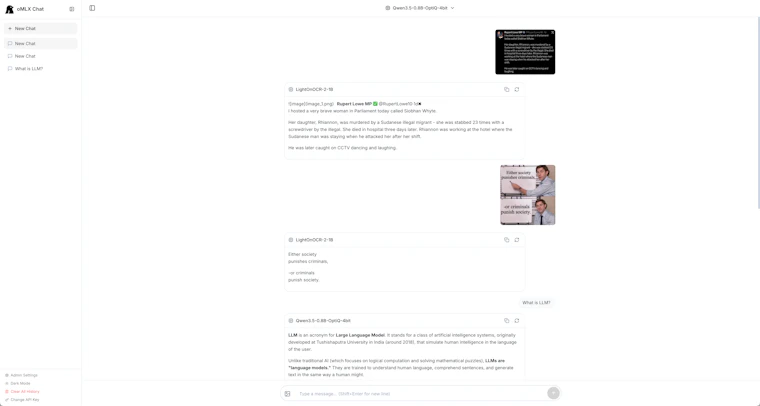
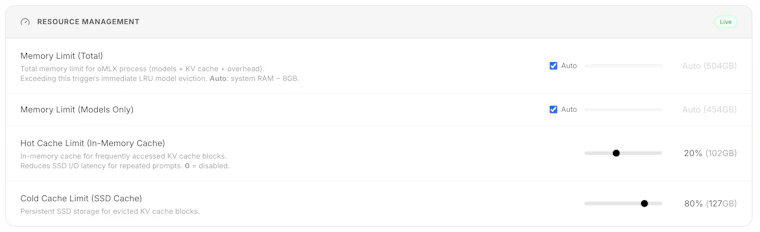
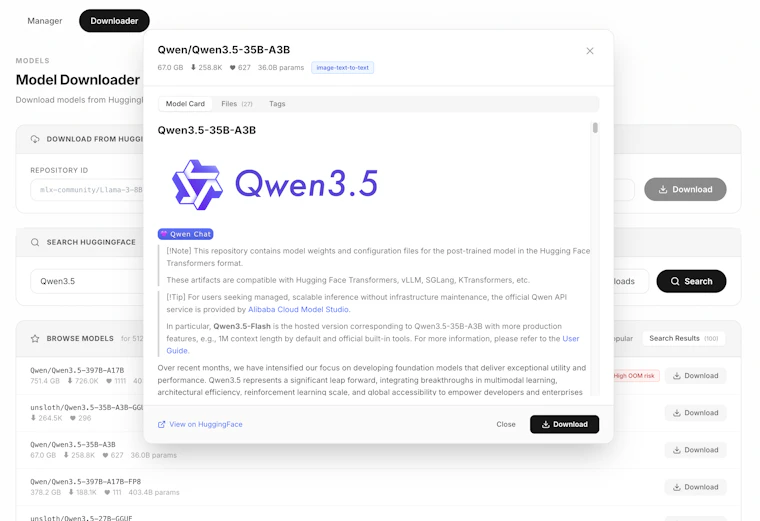
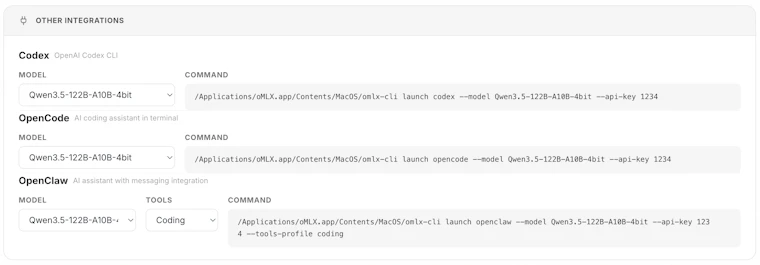
oMLX将您的Mac变身为一站式大语言模型推理服务器,支持菜单栏一键启动。它通过连续批处理技术,高效提供文本、视觉、OCR、嵌入及重排序模型的推理服务;配合独有的RAM+SSD分层KV缓存机制,即使重启也能保留上下文状态。这使得Claude Code与Cursor等开发工具的响应时间从约90秒大幅缩短至5秒左右。原生兼容OpenAI与Anthropic API接口,无缝对接现有工作流。采用纯Swift原生开发,摒弃Electron臃肿框架,遵循Apache 2.0协议开源。
小编简评: oMLX的出现精准击中了本地AI开发者的核心痛点:等待模型加载的漫长煎熬。在Mac生态中,许多同类工具依赖Electron或复杂的命令行配置,而oMLX凭借纯Swift原生架构实现了极致的轻量化与高性能。其最大的亮点在于“连续批处理”与“RAM+SSD分层KV缓存”技术的结合,这不仅大幅降低了显存占用,更打破了应用重启导致上下文丢失的行业难题。对于日常使用Claude Code、Cursor等AI编程助手的开发者而言,它将平均响应时间压缩至5秒级,真正实现了“即开即用”的丝滑体验。此外,完美兼容OpenAI与Anthropic标准API,意味着无需修改现有代码即可平滑迁移。作为遵循Apache 2.0协议的开源项目,oMLX不仅为个人开发者提供了零成本的高效算力方案,也为本地化大模型部署树立了新的性能标杆。无论是追求极致效率的工程师,还是关注数据隐私的AI爱好者,都值得一试。
用户评价:
“终于不用每次重启IDE都干等了,5秒响应太爽了!”
“纯Swift写的确实轻量,内存占用比之前用的Electron方案低多了。”
“完美兼容OpenAI接口,直接替换环境变量就能跑,无缝衔接。”
“分层缓存机制很黑科技,断网重启后上下文居然还在,惊艳。”
“开源免费还能白嫖苹果芯片算力,开发者福音,已给Star。”
关键词:#oMLX #Open Source #Developer Tools #Artificial Intelligence #GitHub #开源软件 #开发者工具 #人工智能
官方网站: oMLX
英文介绍: Mac LLM server that cuts agent wait times from 90s to 5s
oMLX turns your Mac into a full LLM inference server, run from the menu bar. It serves text, vision, OCR, embedding and reranker models with continuous batching, plus a RAM+SSD tiered KV cache that survives restarts, so Claude Code and Cursor respond in about 5s instead of 90s. OpenAI and Anthropic compatible APIs drop straight in. Native Swift, not Electron. Apache 2.0, open source.
以下是产品图片:
官方网站: oMLX
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~