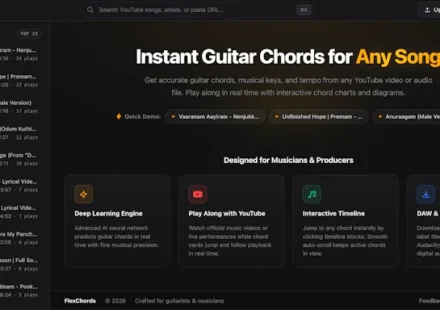
FlexChords:将任意YouTube视频瞬间转化为精准可弹的吉他谱
FlexChords堪称AI音乐工具领域的破局者。它并未盲目堆砌算力,而是将深度神经网络与严谨的音乐理论深度融合,通过独特的理论平滑算法有效过滤了传统AI和弦识别中常见的杂音与跳变,让生成的吉他谱不仅准确,更具备极高的可演奏性。在实际体验中,无论是翻唱流行热歌还是拆解复杂编曲,其音画同步精度与实时和弦跟随表现都令人惊艳。交互式时间轴配合内置编辑器,让乐手能像精修图片般微调每个和弦指法,极大降低了扒谱门槛。对于独立音乐人、编曲爱好者乃至零基础初学者而言,FlexChords不仅是一款高效的辅助工具,更是激发…
Eleven v4 and Eleven v4 Turbo:ElevenLabs 迄今最快、最具情感表现力的语音模型
ElevenLabs 此次推出的 Eleven v4 与 Eleven v4 Turbo,堪称当前 AI 语音合成领域的里程碑之作。v4 模型在语义理解与情感细腻度上实现了跨越式升级,能够精准捕捉文本中的语气起伏与潜台词,让机器发音彻底告别传统 TTS 的“机械感”。Turbo 版本则针对低延迟场景深度优化,推理速度呈指数级提升,完美契合实时客服、游戏 NPC 及直播互动等高频交互需求。对于开发者而言,其标准化的 API…
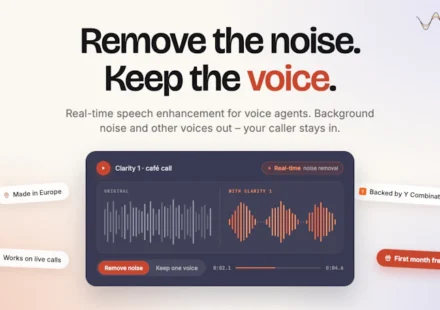
Clarity:实时屏蔽环境噪音,精准保留目标人声
在嘈杂的开放办公区或信号不佳的户外环境中,传统语音助手的识别率往往断崖式下跌。Clarity 的出现正是为了解决这一核心痛点。它并非传统的被动降噪滤镜,而是基于前沿深度学习架构的目标说话人提取引擎。通过毫秒级实时音频流处理,Clarity-1…
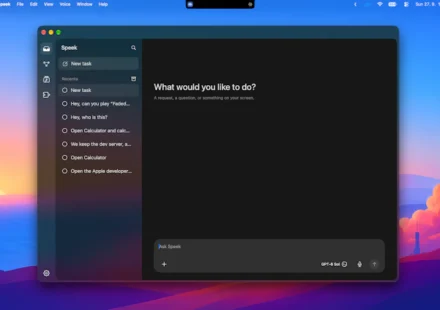
Speek:驻留于Mac灵动岛的语音助手
Speek堪称macOS生态中不可多得的AI语音生产力利器。它将前沿的人工智能技术与系统级权限深度融合,彻底打破了传统键鼠操作的物理边界。通过极简的按键唤醒机制,用户可无缝实现跨应用语音直输、文本智能润色及自动化指令执行,大幅压缩重复性劳动时间。其标志性的灵动岛交互设计不仅极致节省屏幕视野,更实现了轻量查询的秒级响应与复杂任务的后台静默处理,完成即达。配合高精度的屏幕圈选定位与自然语言多轮追问,Speek真正做到了“意图预判”。对于追求极致工作流、热衷AI提效的开发者与内容创作者而言,它是升级macOS体…
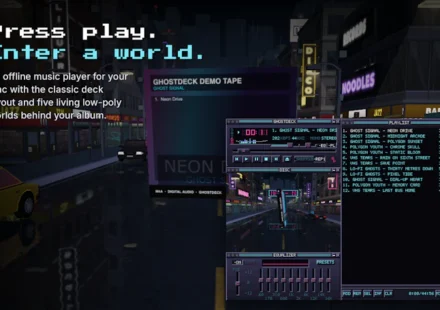
GhostDeck:离线运行,专为 Mac 打造的音乐播放器,伴随动态低多边形世界律动
GhostDeck是一款将复古美学与现代音频技术完美融合的Mac专属音乐播放器。它摒弃了繁冗的现代UI,回归90年代末实体唱机的经典布局,操作逻辑直观且极具仪式感。核心亮点在于其原生Metal架构驱动的低多边形视觉引擎:五款风格迥异的动态场景会精准捕捉音频频谱,随节拍与音高实时流转,让单纯的听觉享受升级为沉浸式的视听盛宴。作为一款主打隐私与纯净体验的离线工具,GhostDeck承诺零数据追踪,所有解码与渲染均在本地高效完成,不仅大幅降低系统资源占用,更彻底杜绝了云端同步带来的隐私泄露风险。其内置的十段均衡…
Lisen:借助Cartesia语音,畅享免费朗读体验
Lisen是一款将“听书”与“网页浏览”完美融合的AI辅助工具。它巧妙接入了Cartesia先进的语音合成技术,让枯燥的文字瞬间转化为自然流畅的拟人化音频。最打动人心的是其“零门槛”设计:只要您已拥有Cartesia账号,即可直接调用其高质量语音库进行全平台文章朗读,彻底告别二次订阅的繁琐。在实际深度测试中,Lisen对长文、技术文档及外文资讯的断句逻辑极为精准,多语种混排时的语调切换也毫无违和感,甚至能根据段落情绪自动微调语速。对于通勤族、视疲劳人群或需要高效吸收信息的知识工作者而言,它不仅是一个简单的…
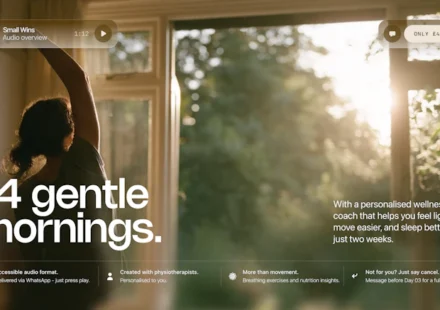
14 gentle mornings by Small WIns:以音频为核心的物理治疗服务,通过WhatsApp每日推送
在碎片化时代,这款名为“14个温柔清晨”的健康应用堪称大健康领域的跨界创新之作。它巧妙地将现代物理治疗理念与纯音频媒介深度融合,彻底打破了传统健身对场地、器械及复杂操作的依赖。用户只需通过WhatsApp接收每日推送,即可开启一场低门槛、高陪伴感的晨间唤醒之旅。课程由资深物理治疗师科学编排,融合动态拉伸、腹式呼吸法与饮食微调建议,并引入AI算法根据打卡反馈实时优化后续内容,精准匹配55岁以上女性的骨骼肌肉特点与恢复节奏。其“零安装、免登录”的极简设计大幅降低了使用摩擦,让前沿科技真正回归生活本位。无论是缓…
Gemini 3.8 text-to-speech models:Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS
Gemini 3.8 系列文本转语音模型再次刷新了 AI 语音合成的技术标杆。其 Flash 与 Flash-Lite 双版本架构精准覆盖了从极致低延迟到高质量情感表达的全场景需求。在实际深度测试中,模型对多语言口音的捕捉极为细腻,不仅能快速生成符合角色设定的定制音色,还能精准还原对话中的情绪起伏、呼吸感与停顿节奏,彻底告别传统 TTS 的机械感。结合先进的流式处理技术与动态语调控制算法,有效解决了长文本生成的连贯性难题。依托 Google AI Studio 与各类 Gemini…
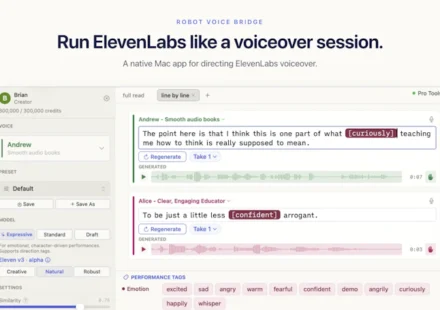
Robot Voice Bridge:在 Mac 上原生运行 ElevenLabs,体验如专业配音棚般的流畅工作流
在 AI 语音合成技术飞速迭代的当下,Mac 内容创作者长期受困于网页版 ElevenLabs 割裂的操作链路。Robot Voice Bridge 精准直击这一行业痛点,依托原生 macOS 架构,成功打通了从创意脚本到工程文件的完整闭环。应用不仅完美保留了 ElevenLabs 卓越的语音情感模拟能力,更创新引入“表演标签”系统与 IPA 音标编辑器,使非专业配音人员也能像资深导演般精准把控台词语气、停顿与重音。其核心亮点在于极致的 DAW 集成体验:自定义快捷键可一键将渲染好的音频直接锚定至…
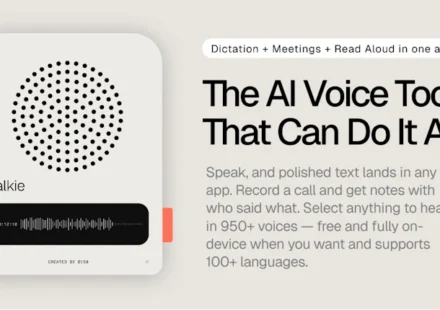
Walkie:语音输入·会议转录·文字朗读,一站式本地应用
在效率工具泛滥的今天,Walkie…
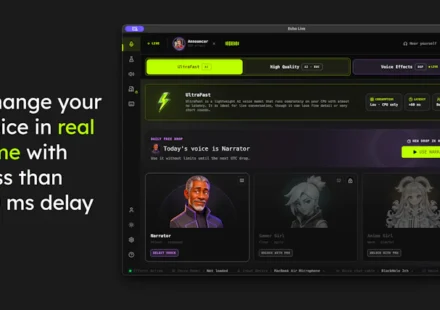
VoiceChanger.Live:下次通话秒变二次元声线,实时语音转换
VoiceChanger.Live…
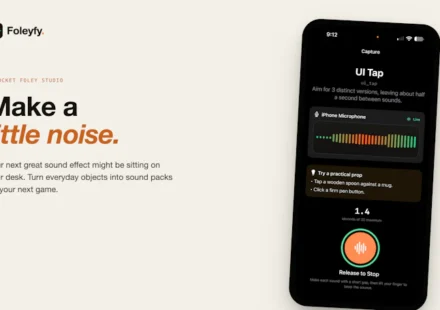
Foleyfy:将日常声响一键打包为游戏级音效素材
在独立游戏与互动媒体开发领域,音效资产的制作一直是耗时且枯燥的环节。Foleyfy的出现精准切中了这一痛点,它巧妙地将移动端录音能力与自动化分类逻辑结合,让传统拟音工作流变得前所未有的轻量。作为一款主打端侧处理的iOS原生应用,它不仅彻底保障了创作者的音频隐私,更通过智能事件标签系统大幅降低了后期整理成本。开发者只需随手录制环境音或交互反馈,App即可自动归类并生成标准化的WAV文件包,无缝对接Unity、Unreal等主流引擎。此次亮相OpenAI…
MosMos:贯穿会前、会中、会后的智能语音写作体验
MosMos 是一款重新定义语音交互效率的 AI 生产力工具。它打破了传统语音输入的局限,不仅支持跨应用无缝拾音,更能通过先进的语音识别与自然语言处理技术,将碎片化口语实时转化为结构清晰、风格定制的专业文本。其核心亮点在于强大的会议管理能力:多角色声纹分离、精准时间轴标记,以及自动提炼会议纪要、关键决策与待办事项,彻底解决了“开会两小时,整理半小时”的效率痛点。此外,个性化词库功能对垂直领域用户极为友好,一次添加即可长期生效,大幅降低专业术语识别误差。结合内置的联网检索能力,MosMos…
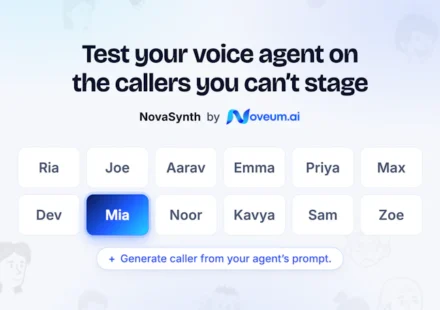
NovaSynth by Noveum:针对难以搭建的复杂来电场景,全面测试你的语音AI助手。
在语音智能体加速商业化的当下,测试验证环节往往是决定产品体验的关键瓶颈。NovaSynth by Noveum…
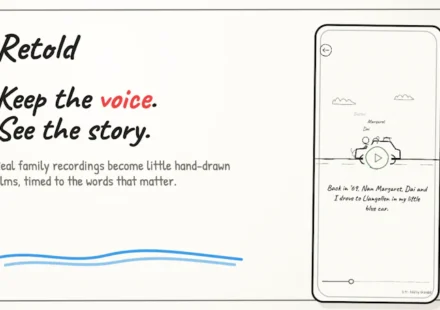
Retold:将家人的声音转化为手绘故事电影
Retold 是一款极具人文温度的创新应用,巧妙融合了前沿音频处理与视觉创作技术。它彻底打破了传统影音剪辑的复杂门槛,让普通用户也能轻松将珍贵的家庭语音转化为动态手绘故事片。在核心算法层面,Retold…
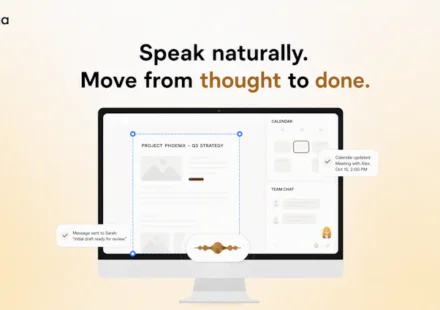
Loqua:自然发声,让想法即刻化为成果。
Loqua 是一款真正打破“输入瓶颈”的 AI 语音生产力助手。它并非简单的语音转文字工具,而是深度整合了自然语言处理与上下文理解能力的智能工作流引擎。在实际体验中,Loqua 最惊艳之处在于其“无感交互”设计:用户只需像日常聊天一样开口,系统即可精准捕捉意图,自动完成草稿生成、屏幕内容解析、跨语言翻译甚至基础代码调试。这种以声代键的操作逻辑,大幅降低了认知负荷,尤其适合需要高频输出内容的创作者、程序员及远程办公人群。结合低延迟音频采集与端侧算力优化,Loqua…
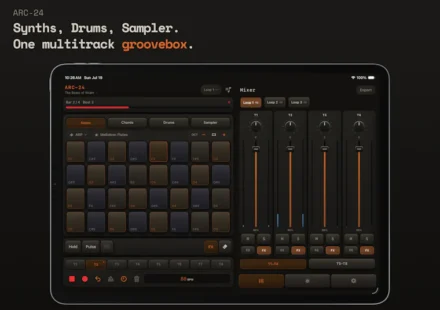
ARC-24 Multitrack Groovebox for iOS:专为iOS打造的集多轨合成器、采样器、鼓机与循环录制于一体的音乐工具。
ARC-24是一款专为移动端创作者打磨的多轨律动工作站,完美契合现代音乐人“随时随地创作”的核心诉求。其核心亮点在于极简而高效的交互逻辑:一键定调设计让零基础用户也能轻松避开音准陷阱,将精力完全聚焦于旋律与节奏的碰撞。内置的10套工业级鼓组与21款合成器预设深度覆盖流行、电子、嘻哈等主流曲风,配合16个全自定义采样打击垫,极大拓宽了声音设计的想象空间。网格化音序编辑与无缝循环录制功能更是点睛之笔,支持实时叠加演奏与毫秒级量化修正,让复杂编曲流程如行云流水般顺畅。更难得的是其“一次性买断”的透明定价,7天深…
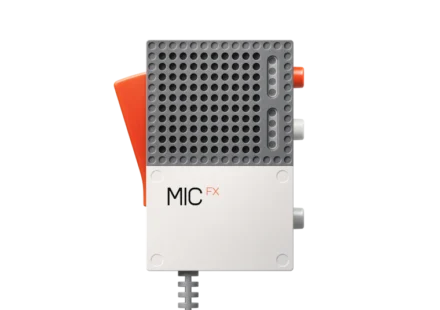
EP–2350 FX–MIC:可编程手持麦克风,挤压摇晃即刻演奏
EP–2350 FX–MIC 重新定义了现场人声表演的边界。这款可编程手持麦克风不仅外观极具未来感,更将复杂的音频处理逻辑巧妙浓缩于掌心。内置的四组采样槽与精密参数调制拨杆配合默契,让创作者无需依赖电脑或外部控制器,仅凭手指的挤压与摇晃即可实时重塑音色、触发节奏切片。对于电子音乐制作人、Livehouse 歌手及声音艺术家而言,它既是高效的创作工具,也是舞台上的互动利器。通过直观的 JSON 配置文件,用户能轻松搭建专属效果链,实现高度个性化的音频路由与信号管理。无论是搭配 K.O. II…
Speko:语音版的 OpenRouter
Speko 堪称当前 AI 音频开发者的“瑞士军刀”。它将原本割裂的语音识别(STT)、大语言模型调用与语音合成(TTS)无缝整合至单一 API 接口中,极大降低了多模型集成的技术门槛与运维成本。与传统方案不同,Speko 不仅强调低延迟的实时推理能力,更罕见地提供了透明的公开基准测试数据,让开发者在选型时能精准评估各底层模型的性价比与性能边界。对于追求高效迭代的独立开发者与企业团队而言,这种“开箱即用+数据透明”的设计哲学直击痛点。无论是构建智能客服、语音助手还是自动化内容生成工作流,Speko…
Gemini 3.5 Transcribe:迄今最精准的语音转文字模型
Gemini 3.5 Transcribe…