oMLX:让智能体等待时间从90秒骤降至5秒的Mac本地LLM推理服务器
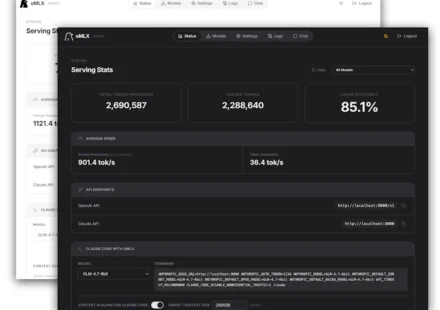
oMLX的出现精准击中了本地AI开发者的核心痛点:等待模型加载的漫长煎熬。在Mac生态中,许多同类工具依赖Electron或复杂的命令行配置,而oMLX凭借纯Swift原生架构实现了极致的轻量化与高性能。其最大的亮点在于“连续批处理”与“RAM+SSD分层KV缓存”技术的结合,这不仅大幅降低了显存占用,更打破了应用重启导致上下文丢失的行业难题。对于日常使用Claude…
oMLX的出现精准击中了本地AI开发者的核心痛点:等待模型加载的漫长煎熬。在Mac生态中,许多同类工具依赖Electron或复杂的命令行配置,而oMLX凭借纯Swift原生架构实现了极致的轻量化与高性能。其最大的亮点在于“连续批处理”与“RAM+SSD分层KV缓存”技术的结合,这不仅大幅降低了显存占用,更打破了应用重启导致上下文丢失的行业难题。对于日常使用Claude…