Soup CLI:在 4GB 笔记本显卡上微调 80 亿参数大语言模型
在 4GB 笔记本显卡上微调 80 亿参数大语言模型
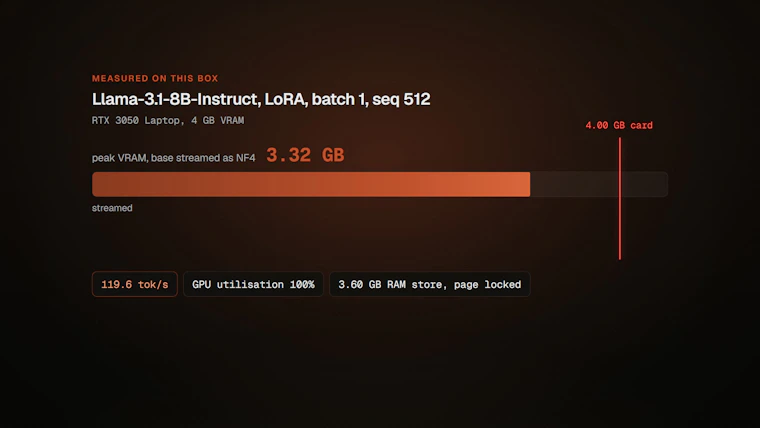
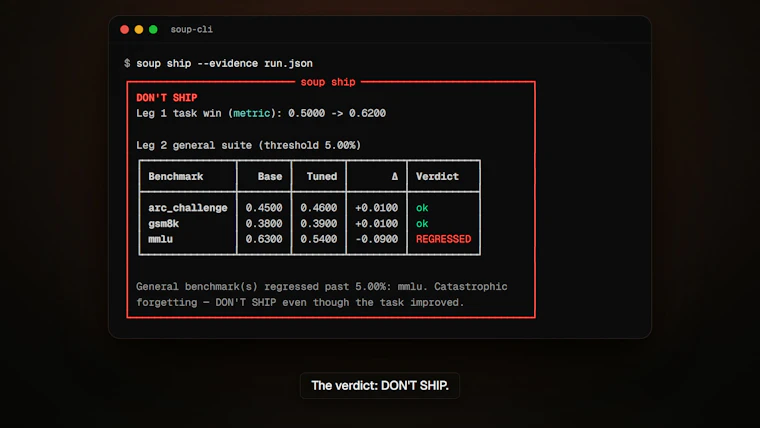
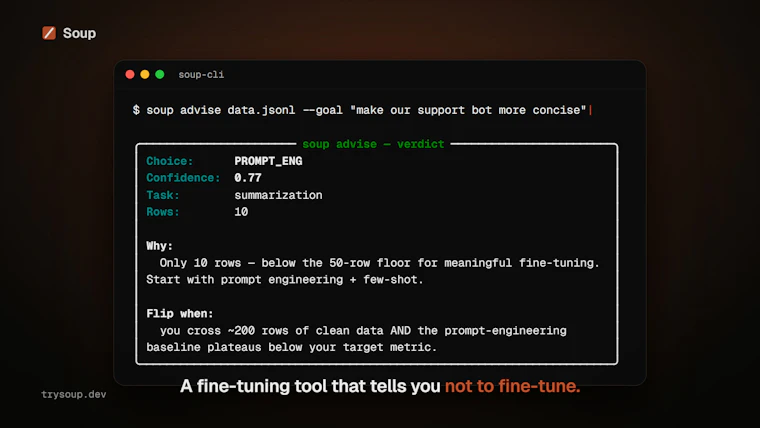
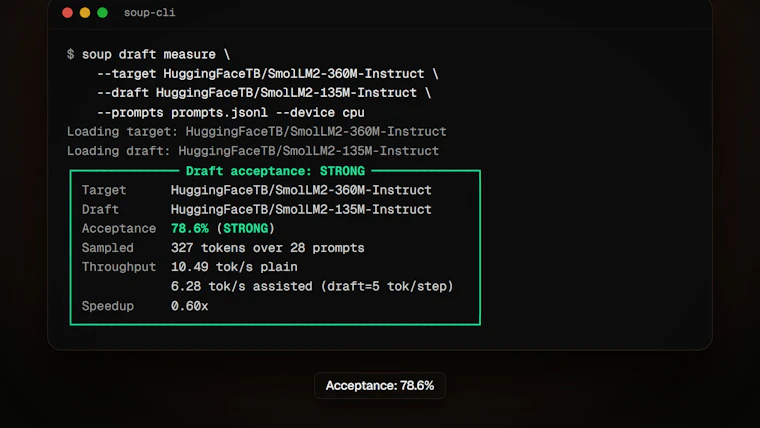
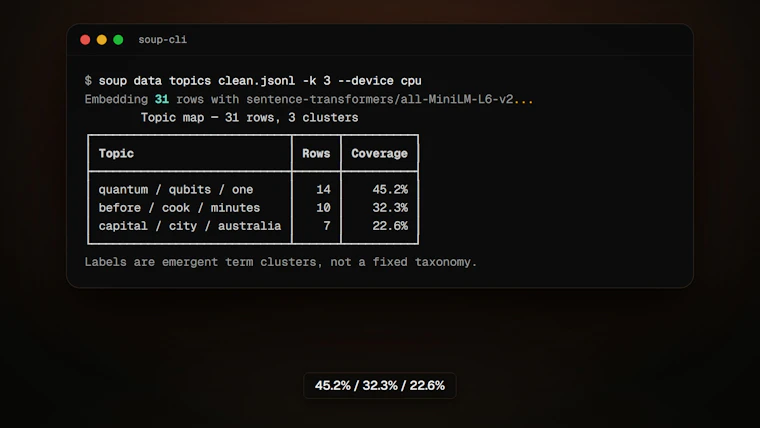
LoRA 技术可冻结基础模型:仅读取权重而不进行写入更新。Soup 巧妙地将模型驻留于系统内存,按需逐层流式加载至 GPU。此举将峰值显存需求从全量模型压缩至单一网络层。实测搭载 RTX 3050 笔记本显卡(4GB)设备时,Llama-3.1-8B 训练速率可达 119.6 tok/s,峰值显存占用仅为 3.32 GB。仅需编写一份 YAML 配置文件并执行单条指令,即可启动全流程。全面支持 SFT、DPO、GRPO、KTO 等主流对齐算法,并集成模型评估、动态门控控制及多格式导出功能。项目严格遵循 Apache-2.0 协议开源,所有基准测试数据均完整公开,涵盖作者实测后主动舍弃的原始日志,确保结果高度可复现。
小编简评: Soup CLI 堪称低配硬件玩家的“微调神器”。在消费级笔记本显卡普遍受限于显存瓶颈的今天,它通过创新的内存分层流式加载架构,成功打破了 8B 模型必须依赖高端算力卡的刻板印象。实测数据显示,其不仅将峰值显存压榨至极限,更保持了惊人的训练吞吐量。对于追求极致效率的 AI 开发者而言,Soup 摒弃了繁琐的环境配置,以“一 YAML 一命令”的极简哲学大幅降低上手门槛。更难得的是其极致的透明度——连被废弃的测试数据也全盘公开,这种硬核态度在当下浮躁的开源社区中尤为珍贵。无论是快速验证业务逻辑,还是进行轻量级垂直领域适配,Soup CLI 都能提供稳定可靠的底层支撑,是每位 AI 工程师本地化部署与模型迭代不可或缺的利器。建议搭配高速 SSD 使用以获得最佳 IO 体验。
用户评价:
“显存占用真的小,我的老笔记本终于能跑微调了!”
“配置简单到离谱,一行命令直接起飞,强烈推荐!”
“数据全公开这点很良心,跑出来的指标完全可信。”
“适合学生党练手,不用租云服务器也能玩大模型。”
“导出功能很实用,无缝对接后续部署流程。”
关键词:#Soup CLI #Open Source #Developer Tools #Artificial Intelligence #GitHub #开源 #开发者工具 #人工智能
官方网站: Soup CLI
英文介绍: Fine-tune an 8B LLM on a 4 GB laptop GPU
LoRA keeps the base model frozen: read, never written. So Soup keeps it in system RAM and streams it into the GPU one decoder layer at a time. Peak VRAM becomes one layer instead of the whole model. Measured on an RTX 3050 Laptop 4 GB: Llama-3.1-8B trains at 119.6 tok/s in 3.32 GB peak. One YAML, one command. SFT, DPO, GRPO, KTO, plus eval, gating and export. Apache-2.0. Every number is published, including the ones I measured and threw away.
以下是产品图片:
官方网站: Soup CLI
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~