oqoqo:为真实场景构建评估体系与自定义基准测试
为真实场景构建评估体系与自定义基准测试
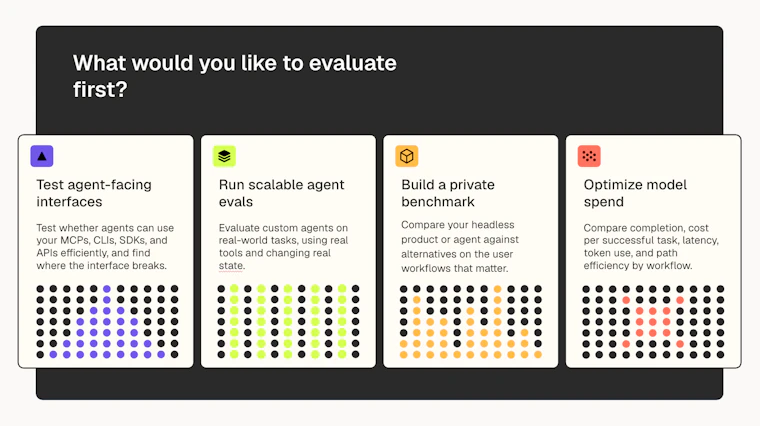
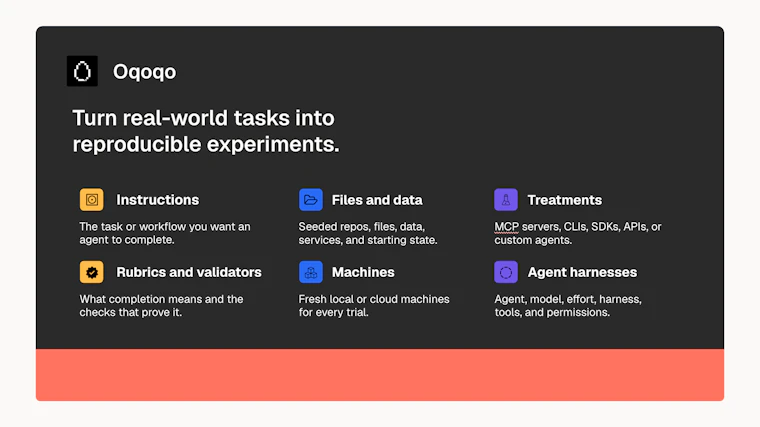
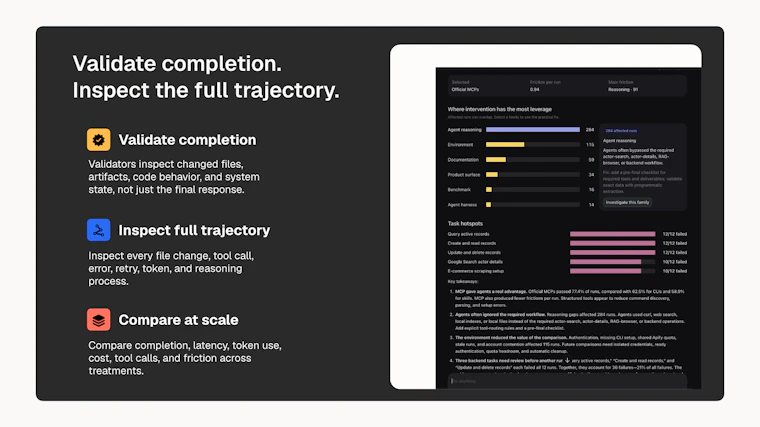
在贴近真实的复杂环境中大规模运行评估实验。通过定义自定义任务集构建专属基准,精准衡量AI智能体操作各类产品的能力,并筛选出最契合业务场景的模型。实时生成动态洞察,快速定位产品交互摩擦点或Token消耗瓶颈,助力研发效能跃升。
小编简评: 在AI应用落地进入深水区后,如何科学量化智能体的实际表现已成为工程团队的核心痛点。oqoqo 正是为此而生的一款利器。它打破了传统评测工具仅依赖静态数据集的局限,支持在高度仿真的业务环境中开展大规模自动化评估。开发者只需配置自定义任务流,即可搭建企业级私有基准库,直观对比不同模型在真实交互中的成功率、响应延迟与资源消耗。其内置的动态分析引擎能精准捕捉界面交互断点与Token冗余调用,将抽象的性能数据转化为可执行的优化建议。对于追求极致体验与成本控制的研发团队而言,oqoqo 不仅是一套评测框架,更是驱动产品迭代与模型选型的数据中枢。它将复杂的Agent调优过程标准化、可视化,真正让“以数据驱动决策”在AI工程化场景中落地生根,大幅缩短从原型验证到规模化部署的周期。
用户评价:
“终于不用手动跑脚本测模型了,自定义任务太省心!”
“界面交互卡顿和Token浪费一眼就能看出来,神器。”
“帮我们挑出了性价比最高的基座模型,上线效果很稳。”
“适合重度开发者,文档清晰,接入很快,推荐试试。”
关键词:#oqoqo #Software Engineering #Developer Tools #Artificial Intelligence #软件工程 #开发者工具 #人工智能
官方网站: oqoqo
英文介绍: Build evals and custom benchmarks for real-world tasks
Run eval experiments at scale in realistic environments. Define custom task sets to build your private benchmarks, measure how well agents can use any product, and find best models for your use cases. Generate dynamic insights to detect frictions in product interfaces or token inefficiencies.
以下是产品图片:
官方网站: oqoqo
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~