
Fluid:专为解决问题而生的语音到语音模型
Fluid这款语音到语音模型给人的第一印象就是"能说会道"。它不仅支持24种以上语言和52种方言,还能在τ²-bench基准测试中解决84%的客服任务——这个成绩在同类产品中相当亮眼。最让我欣赏的是它"会踢球"的设计理念:遇到复杂问题时,可以自动委托给你指定的前沿大模型处理,自己则专注于语音交互环节,这种分工协作的架构非常聪明。兼容OpenAI Live…

Scribe v3 by ElevenLabs:支持90多种语言的语音转文字,错误率降低27%
ElevenLabs这次在Scribe v3上确实是下了一番硬功夫。语音转文字这个赛道竞争激烈,但能把词错误率压低27%的同时还支持90多种语言,说明模型训练的数据量和覆盖范围都达到了新的高度。最让我惊艳的是它的说话人分离能力——32个说话人的标签在多人圆桌、会议辩论这类复杂场景下简直太实用了,普通转录工具在这里早就乱成一锅粥。再加上对笑声、音乐和情绪的标注,以及最多15小时的超长文件处理,Scribe…

Kivo:免费本地语音输入,适用于任意 Mac 应用与 AI 智能体
Kivo 是一款令人眼前一亮的 Mac 端本地语音输入工具,完美契合了当下隐私优先与 AI 提效的双重趋势。其核心亮点在于“按住说话、松开即打”的极简交互,彻底打破了传统云端听写的延迟与卡顿。更值得称道的是,它内置的智能清洗引擎能自动剔除“嗯、啊”等口语赘词,并实时修正口误,让输出文本直接达到可发布级别。对于深度依赖 AI 智能体的创作者而言,Kivo 无缝衔接各类应用的特性堪称杀手级功能,无论是撰写长邮件还是调试…

Mmory:Mmory是一款专为iPhone打造的私密语音记忆应用
Mmory在当下泛滥的云端笔记应用中杀出了一条清流,其核心卖点“全本地处理”直击用户隐私痛点。它巧妙融合了语音输入、AI转录与智能问答功能,让记录灵感不再受限于键盘。无论是通勤途中的即兴口述,还是会议现场的快速备忘,Mmory都能通过端侧大模型实现毫秒级转写与深度语义理解。更难得的是,它彻底摒弃了传统云同步的繁琐与风险,所有数据仅在iPhone芯片内闭环流转,真正做到了“阅后即焚”般的绝对安全。对于追求高效知识管理、注重数据安全的创作者与职场人士而言,Mmory不仅是一款生产力工具,更像是一位懂你节奏的私…

Pauta:每一次对话的专属私密记忆
在数据安全日益敏感的今天,Pauta 以“全离线+本地化”架构重新定义了音频智能处理的标准。它并非依赖云端算力的传统录音工具,而是将先进的端侧 AI 模型深度集成于设备内部,确保每一次会议、访谈或语音备忘的转录与解析都在本地闭环完成。这不仅彻底杜绝了数据上云的风险,更大幅降低了网络延迟,让实时转写与语义分析如丝般顺滑。其核心亮点在于强大的自然语言处理能力:一键生成结构化摘要、自动提取关键决策与待办事项,真正将碎片化语音转化为可执行的工作流。对于注重隐私的专业人士、媒体从业者及远程团队而言,Pauta…

AudioCentral:从 Mac 菜单栏掌控所有应用的音频。
AudioCentral 堪称 Mac 平台的音频管理利器。它将繁琐的系统级声音设置巧妙收敛至菜单栏,实现真正“设置一次,全程省心”的高效体验。核心亮点在于其精细的独立音量控制与多设备路由功能,用户可轻松为每个应用分配专属输出通道,无论是会议时自动压低媒体音量,还是将游戏音效定向推送至耳机,皆能无缝切换。内置的专业级均衡器支持自定义频段调节,搭配先进的 AI 语音隔离算法,能在复杂声学环境中精准提取人声,大幅提升网课与直播的清晰度。更为关键的是,AudioCentral 深度契合 macOS…

Nemotron 3.5 Transcribe:搭载语音大模型的智能转录利器
在语音识别与转录领域,Nemotron 3.5 无疑是一次颠覆性的技术跃迁。作为业界领先的开源语音大模型,它彻底打破了传统 ASR 系统“重识别、轻理解”的固有局限,将自然语言处理与音频流分析深度融合。开发者只需输入一句简单的自然语言指令,模型便能灵活切换逐字实录与规范化排版模式,同时精准剥离说话人身份并标记词级时间戳,彻底告别繁琐的人工校对与后处理流程。更令人惊艳的是,它在涵盖 40…

Vaani Developer Platform:您唯一需要的语音 AI 开发框架
Vaani 开发者平台真正打破了语音 AI 落地的技术壁垒。在生成式 AI 快速渗透各行各业的当下,它凭借“零代码”架构让非技术人员也能轻松构建高拟真度的语音智能体。其核心优势在于对通话逻辑的精细化控制:从话术设计、异议处理到边缘场景容错,全链路可视化配置大幅降低了试错成本。更难得的是,平台不仅关注“听得懂”,更强调“接得住”——通过实时对接企业现有工具链与知识库,确保交互具备实际业务价值。通话结束后自动生成的结构化数据,为后续的客户洞察与模型迭代提供了高质量燃料。对于寻求降本增效的企业而言,Vaani…

Yourcast 2.0:电报内直达:AI摘要配点击跳转时间戳,收听更精准
Yourcast 2.0 堪称 Telegram 生态中播客体验的“破局者”。它将传统碎片化的播客收听流程彻底重构,通过原生机器人实现无缝订阅与即时推送,真正做到了“消息即电台”。2.0 版本的核心亮点在于 AI 技术的深度赋能:动态生成的摘要配合精准的时间戳跳转,让用户在海量内容中快速定位核心观点,大幅降低信息筛选成本。此外,自修复订阅源机制有效解决了 RSS 链接失效的行业痛点,结合高达 2GB 的大文件支持与 OPML 批量迁移,对重度听友极为友好。作为完全遵循 GPL v3…

ElevenLabs Realtime Translation:将实时语音无缝转化为多语种音频,对话即翻译
ElevenLabs 实时翻译重新定义了跨语言沟通的底层逻辑。在传统的语音交互链路中,STT、LLM 与 TTS 的串行处理往往导致明显的延迟与机械感,而该产品凭借单路 WebSocket 架构实现了真正的端到端流式转化。其最大亮点在于“零割裂”体验:不仅能在 90…
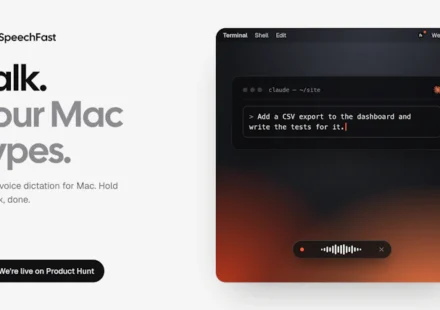
SpeechFast:专为Mac打造的本地Whisper语音工具
SpeechFast 堪称 Mac 用户的隐私级语音生产力利器。在当下云端 AI 语音泛滥的生态中,它坚持“数据不出本机”的硬核理念,彻底打消了企业用户与隐私敏感者的顾虑。基于本地部署的 Whisper 模型,配合 Fn 键一键唤起的极简交互,让打字速度直接突破瓶颈。更令人惊喜的是其对 Apple Intelligence…
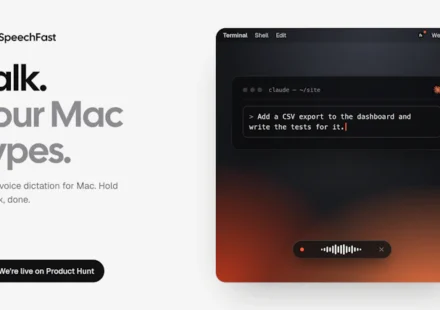
SpeechFast:Mac 专属本地语音输入工具
SpeechFast 堪称 Mac 用户的“隐形打字员”,将本地化 AI 语音识别体验推向了全新高度。与传统依赖云端处理的语音输入方案截然不同,它彻底贯彻了隐私优先原则,所有声学模型加载与实时推理均在本机独立完成,真正做到了“数据绝不离端”。在实际深度测试中,其按键唤醒响应极快,按住 Fn 键即可无缝切入语音模式,即使在嘈杂环境下识别准确率依然坚挺。更令人惊艳的是它与 Apple Intelligence…

Fish Audio Drama 3:不止于生成的AI配音,更可由你亲自执导
Fish Audio Drama 3 的出现,标志着 AI 语音合成从机械朗读正式迈入可导演时代。与传统依赖复杂参数微调的 TTS 引擎不同,Drama 3 真正实现了用自然语言指挥 AI 表演。无论是细腻的情绪递进、呼吸般的节奏把控,还是单句内的耳语与轻笑无缝切换,都能通过直观的文本指令精准落地。对于有声书创作者、独立游戏开发者及短视频博主而言,它大幅降低了多角色配音的门槛,八十三种语言的全覆盖更是让全球化内容分发如虎添翼。更难得的是,Fish Audio…

Maybloc:面向多人音频的语音转文本技术新标杆
Maybloc 是一款专为现代团队协作打磨的 SaaS 级语音转文本解决方案,直击多人会议录音转录的行业痛点。传统工具在处理交叉对话与背景噪音时往往“张冠李戴”,而 Maybloc 凭借自研的高精度声学模型与先进的说话人分离算法,实现了业界领先的转录准确率与极低的 Diarization 错误率。它原生支持 45 种语言及多达 25…
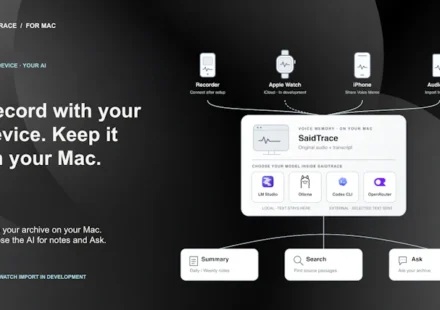
SaidTrace:私密语音备忘,AI由你定义。
在 macOS 生态中,音频处理与人工智能的结合日益紧密,但多数应用往往在隐私保护与模型自由度上做出妥协。SaidTrace 精准切中了这一行业痛点。它不仅是一款高精度的语音转写工具,更是尊重用户数据主权的私人音频管家。依托端到端加密与本地同步架构,所有录音文件均完整留存于个人设备,彻底规避云端传输隐患。其最大优势在于“开放式 AI 接入”——用户可按需调用不同大语言模型,轻松应对学术访谈、商务会议或创意脑暴等多元场景。尤为出色的是“音文溯源”特性:AI…

OpenCouncil:团队与AI同席辩论的语音空间
OpenCouncil重新定义了人机协同的工作流。它巧妙地将主流大语言模型与私有Agent整合进实时语音环境,彻底打破了传统文本协作的效率瓶颈。最核心的亮点在于其“防抢话”协议与双向辩驳逻辑,确保AI在参与讨论时保持专业克制,既能深度交锋观点,又绝不干扰人类主导权。内置的AI书记官能够精准捕捉关键结论并自动生成结构化纪要,将复盘时间压缩至分钟级。此外,公开房间的开放生态极具探索价值,任何用户均可旁听、互动或登台分享,为跨部门脑暴提供了无限可能。底层全面采用Google Cloud…

Orbora:打造个性化引导音频:冥想、呼吸练习与ASMR
Orbora 是一款将前沿 AI 音频生成技术与心理健康管理巧妙融合的移动端应用。它彻底打破了传统冥想类 App 内容固定的局限,通过智能交互路径精准捕捉用户当下的情绪状态与核心诉求,一键生成专属的引导式冥想、科学呼吸训练或沉浸式 ASMR 白噪音。其最大亮点在于高度自由的参数定制能力——从人声音色、语速节奏到背景环境音与主题氛围,均可按需精细调整,真正实现“千人千面”的听觉疗愈体验。底层依托 Google Cloud Run…

Google EmbeddingGemma 2:一款开源、轻量级的多模态嵌入模型
Google EmbeddingGemma 2 的发布再次印证了开源 AI 向轻量化与高效化演进的核心趋势。作为 DeepMind 倾力打造的多模态嵌入模型,它彻底打破了传统单一模态处理的壁垒,将文本、代码、图像、音视频无缝对齐至同一向量空间,极大简化了跨模态检索与语义匹配的开发链路。最引人注目的是其极致的端侧适配能力:7.4 亿参数规模配合精妙的架构优化,使其能在主流移动设备上流畅运行,完整多模态版本内存占用仅约 567MB,真正实现了高性能算力的“本地化下沉”。Apache 2.0…

Unboom:无需声学装修,轻松驯服Mac上的房间低频轰鸣
在家庭录音、线上会议与直播场景中,未经声学处理的房间极易引发低频驻波,导致人声浑浊、监听失真。Unboom 正是为此痛点打造的 Mac 端轻量级音频优化利器。它摒弃了传统昂贵的物理隔音方案,转而通过智能算法精准定位空间共振的“问题频段”,仅对特定低频进行温和衰减,彻底避免传统均衡器“一刀切”带来的音色劣化。操作流程极为直观:利用内置麦克风一键扫描环境频响曲线,或凭借听觉经验手动校准;Gentle、Medium、Strong…