LongCat-2.0:1.6T MoE,完全在AI ASIC上训练
提示:文末链接直达LongCat-2.0官网⬇️⬇️⬇️
产品介绍: 1.6T MoE,完全在AI ASIC上训练
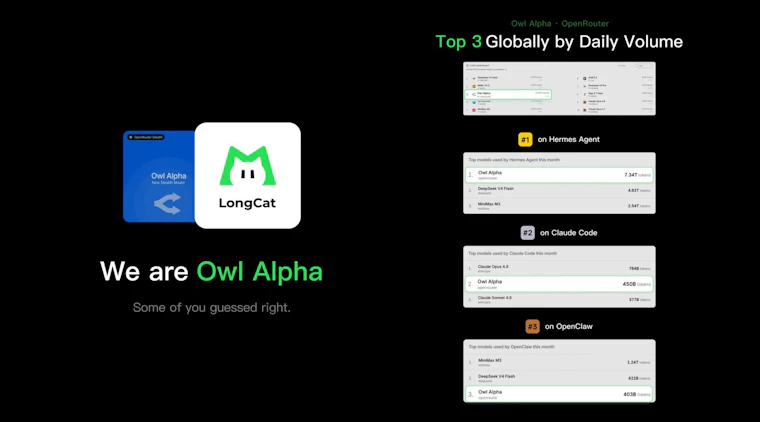
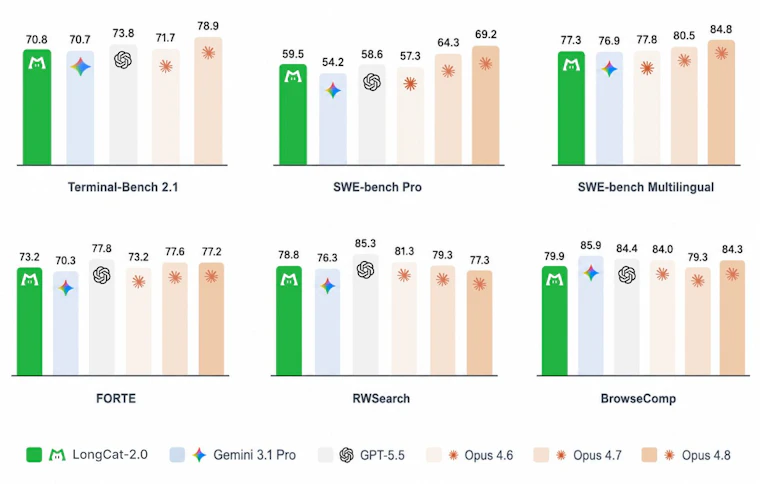
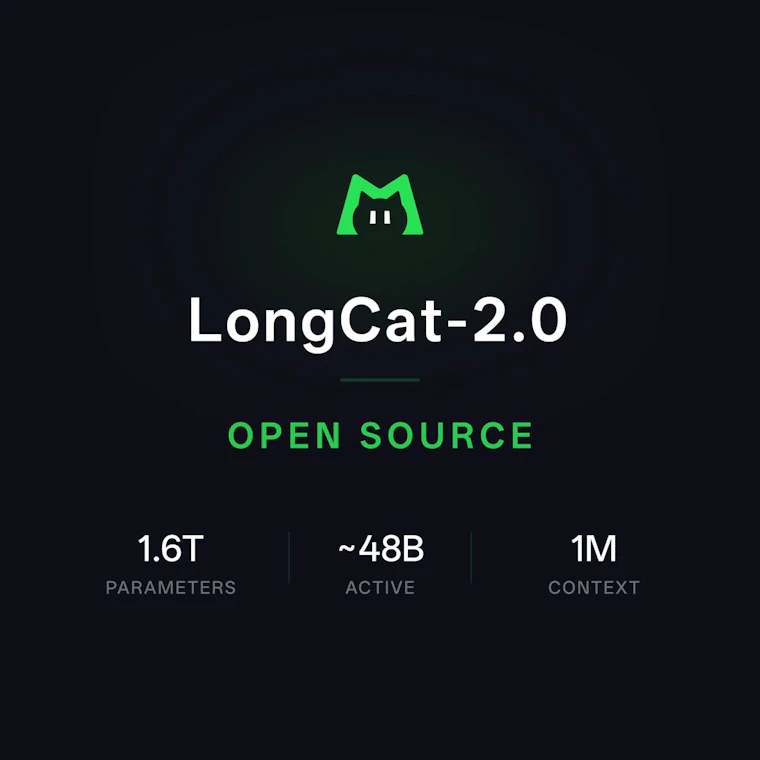
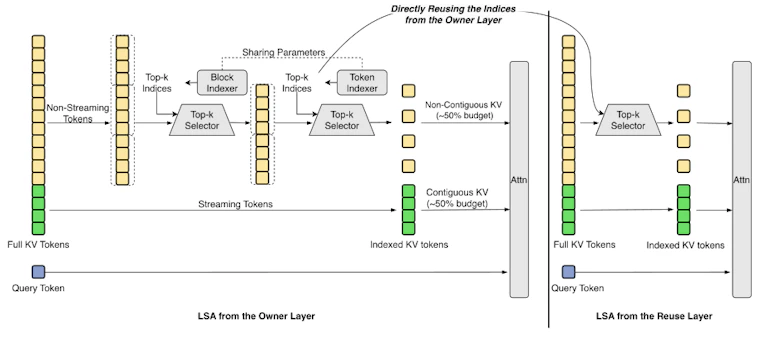
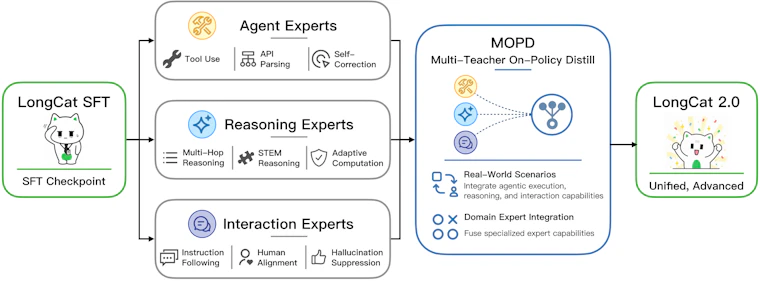
LongCat-2.0 是一个采用 MIT 许可的 1.6T 参数 MoE 模型,具有约 48B 活跃参数、1M 上下文窗口、LongCat 稀疏注意力机制,并针对编码和智能体工作流进行了后训练。该模型在 AI ASIC 超级计算集群上训练,并与 Claude Code、OpenClaw 和 Hermes 集成。
小编简评: LongCat-2.0 以全AI ASIC训练的1.6T MoE架构,仅激活48B参数即实现颠覆性效率,配合1M超长上下文与稀疏注意力,在编码和智能体场景中表现亮眼。MIT开源许可降低了门槛,与Claude Code等工具的深度集成更显生态野心。亮点突出,但硬件依赖和训练成本值得潜在用户权衡。
用户评价:
“处理百万token文档,速度比GPT-4快一倍!”
“稀疏注意力让长代码上下文不再卡顿,开发效率起飞。”
“开源1.6T参数还能跑在普通显卡上?实测48B激活确实香。”
“集成Claude Code后工作流顺畅多了,期待更多插件支持。”
英文介绍: 1.6T MoE trained entirely on AI ASICs
LongCat-2.0 is an MIT-licensed 1.6T-parameter MoE model with ~48B active parameters, 1M context, LongCat Sparse Attention, and post-training for coding and agentic workflows. It was trained on AI ASIC superpods and integrates with Claude Code, OpenClaw, and Hermes.
以下是产品图片:(文末链接直达产品官网⬇️⬇️⬇️)
官方网站: LongCat-2.0
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~