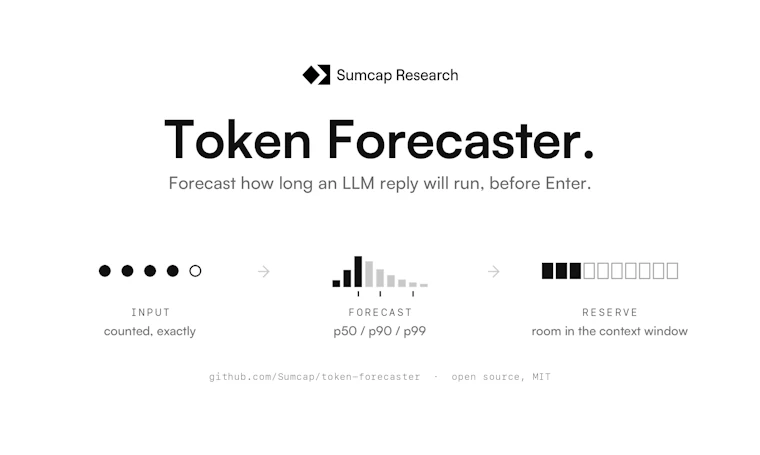
Token Forecaster:在按下回车前,预判大模型回复的生成时长
在按下回车前,预判大模型回复的生成时长
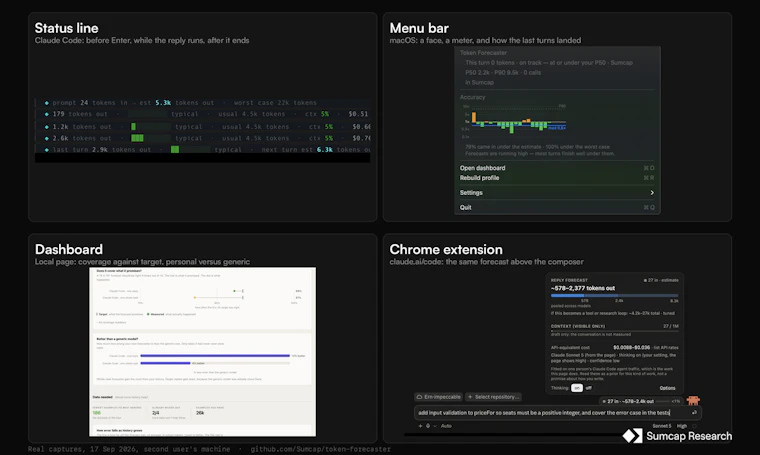
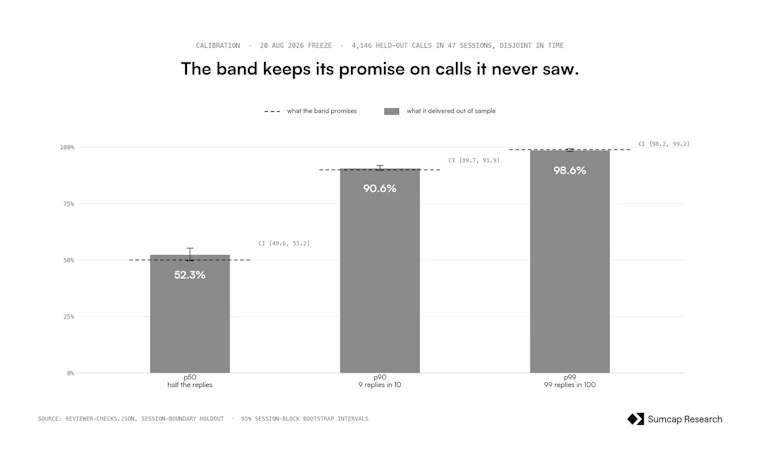
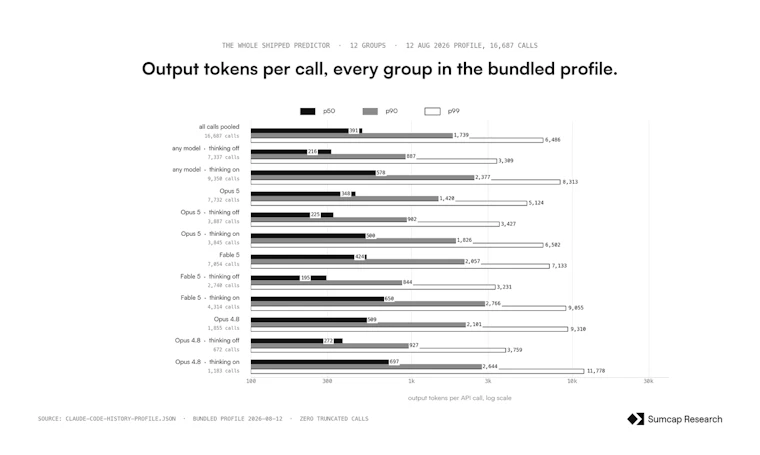
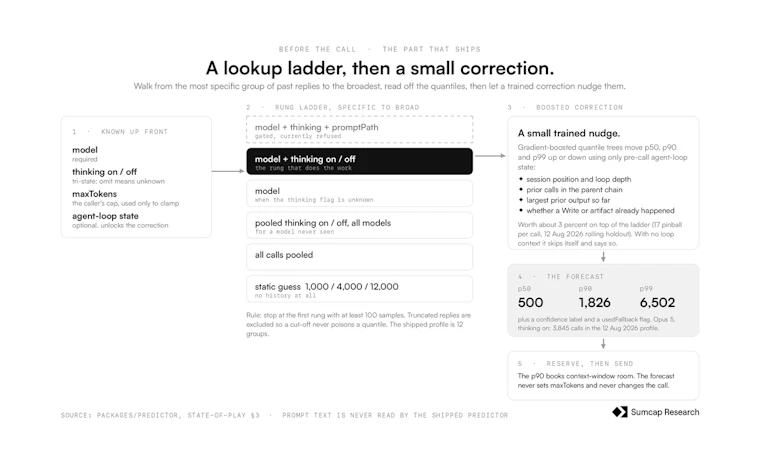
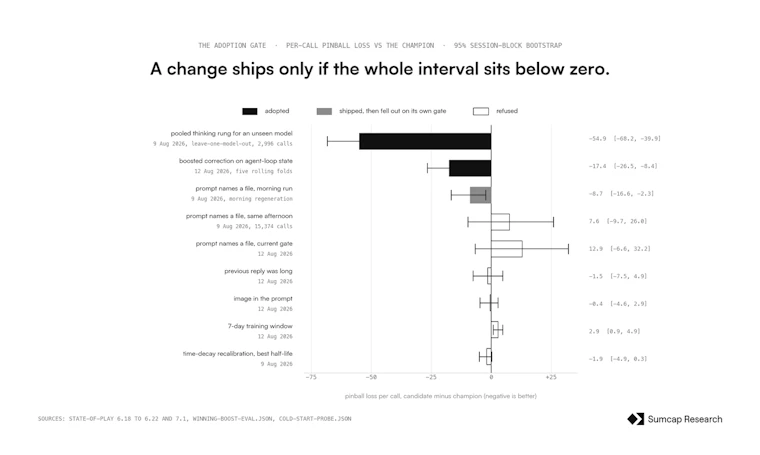
Token预测器可在您按下回车键前,为大模型回复生成时长提供预估区间:包含常规耗时与覆盖90.6%(基于4146次未见调用测试)的最长耗时。回复流式输出期间,它会实时提示是否超出预期。该工具仅静默监控,绝不修改您的原始请求,并支持从本地历史中学习优化。开源协议:MIT。
小编简评: 在大模型交互日益普及的今天,等待 AI 回复的“空白期”曾是开发者最头疼的体验之一。Token Forecaster 精准切中这一痛点,作为一款轻量级 AI 辅助工具,它能在代码提交前智能预判响应时长,给出常规与极限双重视角的时间区间。其最大亮点在于“只读不写”的安全机制——全程静默监控本地历史数据,绝不篡改原始 Prompt,彻底打消了隐私与合规顾虑。依托超过四千次真实调用的训练基准,其预测准确率高达 90.6%,让时间管理变得有据可依。更难得的是,该项目以 MIT 协议完全开源,托管于 GitHub,社区活跃且迭代迅速。无论是追求极致体验的独立开发者,还是注重效能管理的工程团队,都能从中获得流畅的交互节奏。它不仅是一款提升生产力的实用插件,更是开源精神与前沿 AI 技术完美融合的典范,值得每一位关注大模型工作流的极客收藏试用。建议搭配本地大模型环境使用,可进一步压榨延迟瓶颈,让开发流程如丝般顺滑。
用户评价:
“终于不用盯着屏幕干等了,预测挺准的!”
“纯本地运行不传数据,安全感拉满,推荐。”
“界面简洁无广告,GitHub上直接下,好评。”
“配合Ollama用简直绝配,开发效率翻倍。”
“开源良心之作,MIT协议随便改,已加星标。”
关键词:#Token Forecaster #Open Source #Developer Tools #Artificial Intelligence #GitHub #开源项目 #开发者工具 #人工智能
官方网站: Token Forecaster
英文介绍: Forecast how long an LLM reply will run, before Enter
Token Forecaster puts a range on an LLM reply before you press Enter: the usual length, and a worst case that held for 90.6% of 4,146 unseen calls. While the reply streams, it shows whether it is running long. It only watches and never changes the request. Learns from your local history. Open source, MIT.
以下是产品图片:
官方网站: Token Forecaster
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~