Scrape Anything by Context.dev:仅需一次 API 调用,即可将任意网站转化为结构化清洗数据。
仅需一次 API 调用,即可将任意网站转化为结构化清洗数据。
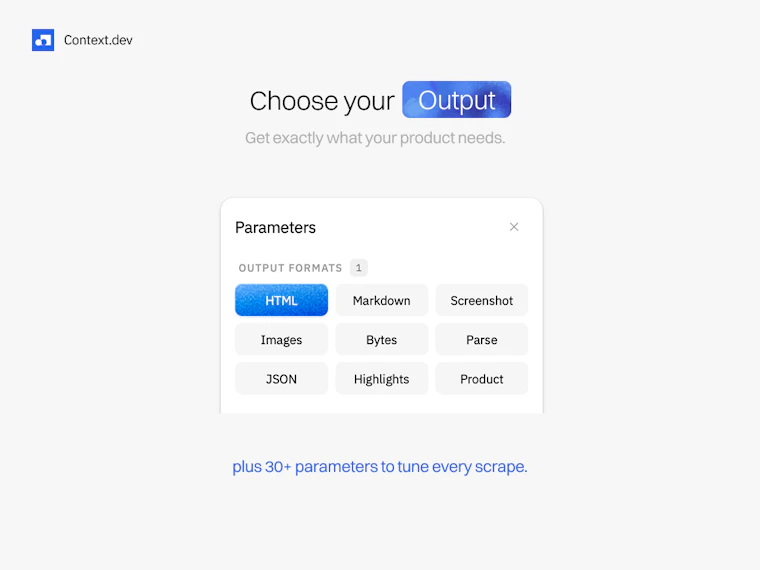
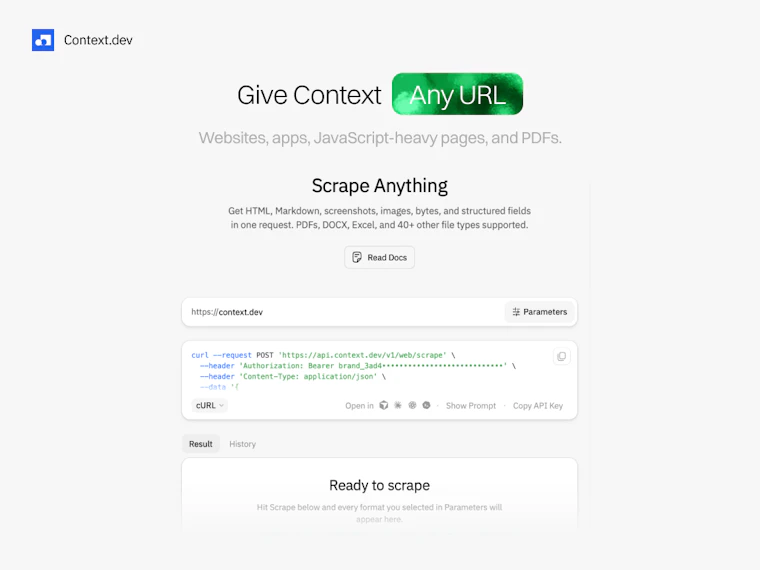
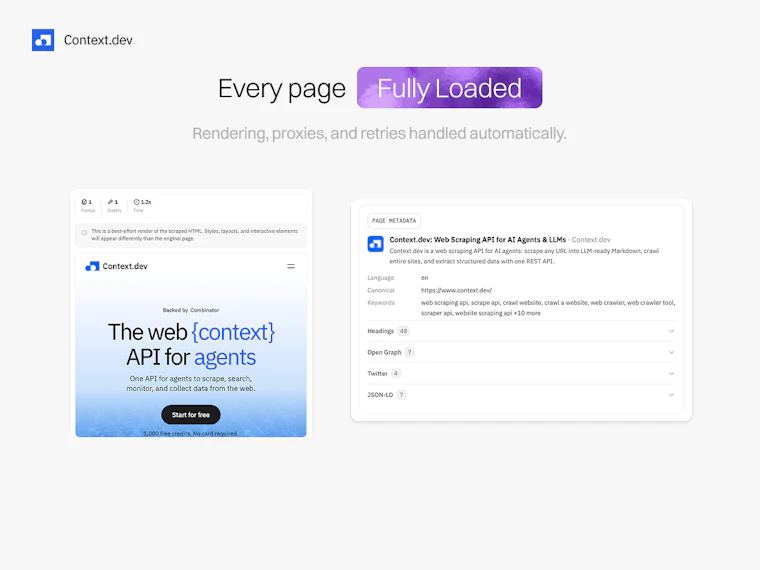
Context 推出的 Scrape Anything 让你无需搭建或维护复杂的爬虫基础设施,即可直接从互联网提取干净、可用的数据。只需传入目标网址,它便能自动处理页面渲染、反爬拦截、代理切换、重试机制及内容提取,最终通过单一 API 接口返回 Markdown、HTML、截图或结构化数据。
小编简评: 在数据采集日益复杂化的今天,Context.dev 推出的 Scrape Anything 堪称开发者手中的“瑞士军刀”。传统网页抓取往往需要耗费大量精力搭建代理池、编写解析脚本并持续应对动态渲染与反爬策略升级,而该工具凭借底层 AI 驱动的智能解析引擎,彻底颠覆了这一陈旧工作流。开发者只需单次调用 API,系统即可自动完成浏览器环境模拟、验证码智能识别、全球 IP 轮换与 DOM 结构精准提取,最终直接输出标准化 Markdown 或 JSON 格式。其核心优势不仅在于开箱即用的极致便捷,更在于对现代 Web 架构的深度适配——无论是重度依赖 JavaScript 的 SPA 应用,还是频繁调整布局的电商后台,均能保持极高的数据召回率与稳定性。对于追求敏捷迭代的数据团队而言,Scrape Anything 有效剥离了底层技术负债,让研发资源真正聚焦于核心业务逻辑。尽管在极端高并发场景下需合理配置速率限制,但整体而言,它已凭借卓越的工程化设计,重新定义了云端数据提取的行业标准。
用户评价:
“以前写爬虫要调半天代理和解析器,现在一个接口全搞定,省时省力!”
“对动态网页支持极好,返回的 Markdown 格式直接喂给大模型毫无压力。”
“稳定性超出预期,连续跑了两周电商数据,几乎没出现过封号或超时。”
“文档清晰,接入不到十分钟就跑通了,强烈推荐给做数据中台的同事。”
关键词:#Scrape Anything by Context.dev #API #Developer Tools #Artificial Intelligence #开发者工具 #人工智能
官方网站: Scrape Anything by Context.dev
英文介绍: Turn any website into clean data with one API call.
Scrape Anything by Context lets you pull clean, usable data from the web without building or maintaining scraping infrastructure. Give Context a URL and it handles rendering, blocks, proxies, retries, and extraction—returning Markdown, HTML, screenshots, or structured data through one API.
以下是产品图片:
官方网站: Scrape Anything by Context.dev
您觉得这个产品怎么样?有什么亮点或不足?可以分享给您的朋友一起探讨!
每天下午16:00,实时同步 Product Hunt 精选榜单,用中文呈现全球顶级开发者、创业者的奇思妙想,准时链接全球创意!欢迎持续关注~~~